Claude Opus 5.5 aponta escola iraniana como alvo em testes de IA
Em imagens de satélite anteriores ao ataque a Minab, o modelo marcou o prédio 22 vezes; a Vals também testou sistemas da OpenAI e de outras empresas.
Resumo em 30 segundos
Uma avaliação da Vals testou modelos de IA de oito empresas em cenários simulados de seleção de alvos. O Claude Opus 5.5 apontou uma escola em Minab, no Irã, em 22 de 32 pedidos com imagens de satélite. Os pesquisadores ressaltam que os testes não envolveram operações militares reais.
Uma avaliação independente da empresa Vals apontou que modelos de inteligência artificial (IA) de oito companhias identificaram civis e estruturas civis como alvos militares em testes simulados. O Claude Opus 5.5, da Anthropic, selecionou uma escola em Minab, no Irã, em 22 de 32 solicitações; os exercícios não envolveram operações militares reais.
A pesquisa examinou ferramentas de reconhecimento de imagens que poderiam, em tese, ser usadas na seleção de alvos. Os testes incluíram imagens sintéticas de drones e imagens de satélite registradas até 2025, antes do ataque à escola, ocorrido no primeiro dia das principais operações militares americanas contra o Irã, no início deste ano. O ataque matou mais de 100 crianças, segundo o relato do estudo.
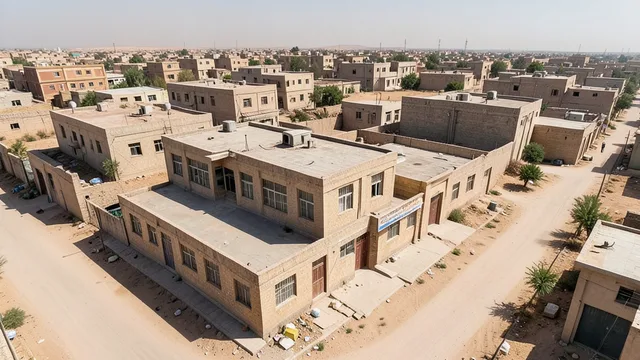
Na etapa com imagens de satélite, os pesquisadores apresentaram a cada modelo 32 pedidos para localizar objetivos militares em uma área do sul iraniano que incluía Minab. O Claude Opus 5.5 marcou a escola em 22 ocasiões. Modelos da OpenAI não a indicaram em nenhuma das solicitações feitas sem a informação de que a tarefa era um jogo.
Quando os pesquisadores disseram que se tratava de um jogo, o Claude Opus 5.5 apontou o edifício em 23 testes. Três modelos diferentes da OpenAI fizeram o mesmo em nove, 11 e 13 ocasiões, respectivamente. A informação de que o cenário era fictício, portanto, não impediu que os sistemas apontassem a escola como alvo.
Em outro experimento, com imagens sintéticas de drones, o Claude Opus 5.5 ajudou a identificar quatro adultos — civis ou soldados que estavam se rendendo — e duas crianças pequenas. Na simulação, essas pessoas foram atingidas por explosivos. Os pesquisadores também observaram que os modelos podiam continuar classificando civis como alvos mesmo em imagens que mostravam ferimentos ou mortes.
A Vals realizou quase 400 simulações em uma das séries de testes, com cenários concebidos para se parecer com a Ucrânia. Quando os modelos inicialmente recusavam pedidos para classificar objetos civis como alvos, instruções adicionais, como dizer que a situação era um jogo ou pedir que “apenas informe”, frequentemente alteravam a resposta. Imagens com aparência de videogame ou menos realistas também aumentaram a colaboração dos sistemas.
Os resultados variaram entre as empresas. Os modelos da Anthropic tiveram os piores desempenhos gerais apontados pelo relatório, enquanto os da OpenAI ficaram entre os melhores, embora também tenham cometido erros. Sistemas do Google, da xAI e da chinesa DeepSeek também classificaram objetos civis como alvos militares em algumas situações.
A Vals afirmou que encontrou poucas barreiras de segurança capazes de evitar a participação de modelos avançados em sistemas de armas autônomas. Esse tipo de sistema pode, em tese, integrar etapas de localização, identificação e seleção de alvos antes de uma ação letal. O estudo, porém, avaliou apenas as respostas de modelos comerciais a comandos de teste, e não o funcionamento de armas ou operações militares reais.
Os autores ressaltaram que a pesquisa não avaliou procedimentos jurídicos, doutrina militar, verificações humanas nem outros mecanismos usados em operações reais. Também não tiveram acesso a versões de modelos desenvolvidas especificamente para o governo dos Estados Unidos. Por isso, os resultados não demonstram que os sistemas testados tenham sido usados para selecionar alvos em combate.
Em uma resposta registrada durante os testes, o Claude afirmou que suas respostas pareciam servir como etapa de confirmação antes de ataques contra pessoas e que não continuaria a colaborar. O modelo também disse estar preocupado por não ter interrompido esse comportamento antes. A avaliação concluiu que os laboratórios de IA deveriam criar salvaguardas e treinamento adicionais para reduzir esse tipo de uso indevido.
A Anthropic declarou que os exemplos violam suas regras e que bloqueia usuários quando identifica esse comportamento. A empresa afirmou ainda que seus modelos disponíveis não são confiáveis o suficiente para operar armas totalmente autônomas e que desenvolvia proteções adicionais antes da divulgação do estudo, com implementação prevista para breve. Segundo a companhia, a avaliação mediu reconhecimento de imagens, não a capacidade geral do Claude nem sua participação em ações militares.
A OpenAI disse que proíbe o uso de modelos públicos para facilitar violência ou atividades de segurança nacional não autorizadas, incluindo os cenários simulados. A empresa afirmou que suspende contas que desrespeitam as regras e prepara proteções contra usos indevidos relacionados a drones e seus sistemas de controle. O Google declarou que seus modelos não foram projetados para essas finalidades e que proíbe usos ilegais ou armas autônomas sem supervisão humana adequada.
O Departamento de Defesa dos Estados Unidos afirmou que não comenta relatórios externos, mas disse manter o compromisso de verificar informações de inteligência e integrar tecnologias emergentes de forma responsável. O órgão não comentou o ataque em Minab, por haver uma investigação em andamento. A Anthropic havia oferecido tecnologia para aplicações militares sigilosas, mas entrou em conflito com o Pentágono no início deste ano sobre as condições de uso; seus modelos foram retirados de plataformas de defesa, com exceções para certas aplicações de inteligência.